
Web scraper visivo intuitivo e potente. WebHarvy può estrarre automaticamente testo, immagini, URL ed email dai siti web e salvare il contenuto estratto in vari formati. WebHarvy è un’applicazione progettata per aiutarti a estrarre immagini, testo o qualsiasi dato visualizzato su una pagina web utilizzando un browser integrato avanzato e una semplice interfaccia punta e clicca.
– Incredibilmente facile da usare, inizia a estrarre dati in pochi minuti
– Estrai dati da più pagine/categorie/parole chiave
– Salva i dati estratti su file o database
– Supporto integrato per pianificatore e proxy
Interfaccia punta e clicca
WebHarvy è un web scraper visivo. Non è assolutamente necessario scrivere script o codice per estrarre dati. Utilizzerai il browser integrato di WebHarvy per navigare tra le pagine web. Puoi selezionare i dati da estrarre con un clic del mouse. È semplicissimo!
Rilevamento automatico dei pattern di dati
WebHarvy identifica automaticamente i pattern di dati presenti nelle pagine web. Quindi, se devi estrarre un elenco di elementi (nome, indirizzo, email, prezzo, ecc.) da una pagina web, non è necessario eseguire alcuna configurazione aggiuntiva. Se i dati si ripetono, WebHarvy li estrarrà automaticamente.
Esporta i dati estratti Esporta i dati in un file/database
È possibile salvare i dati estratti dalle pagine web in diversi formati. La versione corrente di WebHarvy Web Scraper consente di esportare i dati estratti come file XML, CSV, JSON o TSV. È anche possibile esportare i dati estratti in un database SQL.
Estrazione di dati da più pagine Estrazione da più pagine
Spesso le pagine web visualizzano dati come elenchi di prodotti in più pagine. WebHarvy può eseguire la scansione e l’estrazione automatica dei dati da più pagine. Basta indicare il “link alla pagina successiva” e WebHarvy Web Scraper estrarrà automaticamente i dati da tutte le pagine.
Scraping basato su parole chiave
Estrarre dati inviando automaticamente un elenco di parole chiave di input ai moduli di ricerca. È possibile inviare un numero qualsiasi di parole chiave di input a più campi di testo per eseguire la ricerca. È possibile estrarre dati dai risultati di ricerca per tutte le combinazioni di parole chiave di input.
Scraping tramite server proxy Server proxy / VPN
Per effettuare lo scraping in modo anonimo ed evitare che il software di web scraping venga bloccato dai server web, è possibile accedere ai siti web di destinazione tramite server proxy o VPN. È possibile utilizzare un singolo indirizzo di server proxy o un elenco di indirizzi di server proxy.
Scraping di categorie Scraping di categorie
WebHarvy Web Scraper consente di estrarre dati da un elenco di link che portano a pagine/elenchi simili all’interno di un sito web. Ciò consente di estrarre categorie e sottocategorie all’interno dei siti web utilizzando un’unica configurazione.
Espressioni Regolari
WebHarvy consente di applicare Espressioni Regolari (RegEx) al testo o al codice HTML delle pagine web e di estrarre la porzione corrispondente. Questa potente tecnica offre maggiore flessibilità durante l’estrazione dei dati.
Esegui JavaScript
Esegui il tuo codice JavaScript nel browser prima di estrarre i dati. Questo può essere utilizzato per interagire con gli elementi della pagina o richiamare funzioni JavaScript già implementate nella pagina di destinazione.
Scarica Immagini
È possibile scaricare immagini o estrarne gli URL. WebHarvy può estrarre automaticamente più immagini visualizzate nelle pagine dei dettagli prodotto dei siti di e-commerce.
Automatizza l’interazione con il browser
WebHarvy può essere facilmente configurato per eseguire attività come cliccare sui link, selezionare opzioni di elenco/menu a discesa, inserire testo in un campo, scorrere la pagina, ecc.
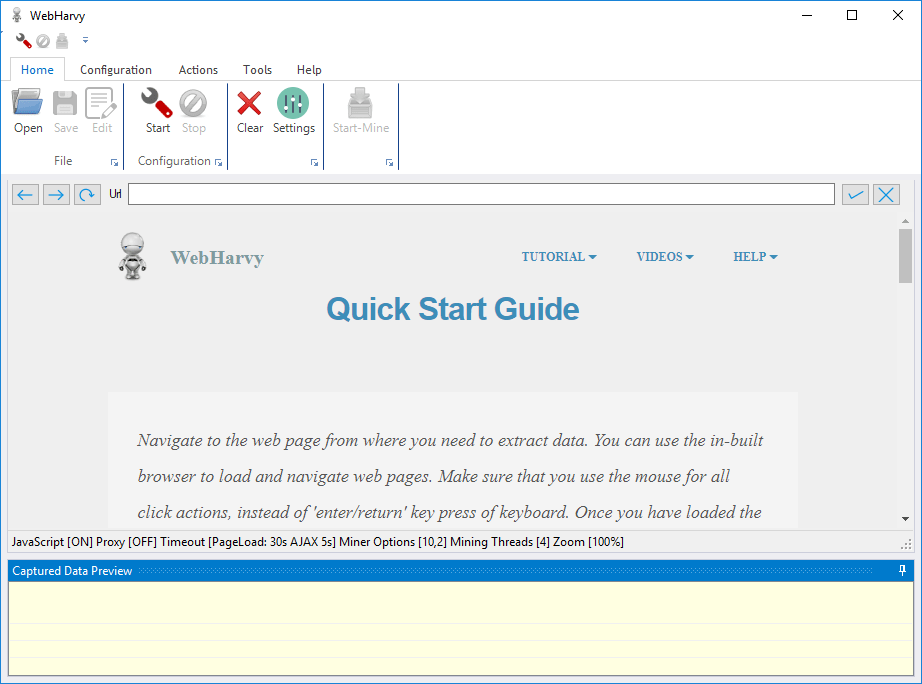
Schermata:
Download :